《为什么我要手搓复刻一个 Agent 框架》
写在前面
最近半年,身边做 AI 的朋友都在聊 Agent。从最开始的”这玩意儿能干啥”,到现在各种 Agent 框架满天飞,这个领域的发展速度快得有点吓人。
作为一个喜欢折腾的技术人,我也忍不住想搞清楚 Agent 到底是个什么东西。看了一圈市面上的框架,最后决定自己手搓一个。
这篇文章就聊聊我在这个过程中的一些思考和收获。
一、Agent 是个啥?跟 LLM 有啥区别?
先说 LLM
如果你看过我之前写的 LLM 个人笔记,应该知道 LLM 本质上就是个”词语接龙”游戏:
- 你输入一个问题
- 它根据训练数据,一个词一个词地生成回答
- 整个过程是一次性的,输入进去,输出出来,就结束了
用个比喻:LLM 就像一个博学的朋友,你问他问题,他给你答案。但他只会”说”,不会”做”。
再说 Agent
Agent 就不一样了。它不只会”说”,还会”做”。
核心区别:
| 维度 | LLM | Agent |
|---|---|---|
| 交互方式 | 一问一答 | 多轮迭代 |
| 能力范围 | 只能生成文本 | 可以调用工具、执行操作 |
| 工作流程 | 输入 → 输出 | 观察 → 思考 → 行动 → 反馈 → 循环 |
| 自主性 | 被动响应 | 主动规划 |
还是用比喻:
- LLM:你问”今天天气怎么样”,它会根据训练数据告诉你”一般是…“,但它不知道今天真实的天气
- Agent:它会先想”我需要查天气”,然后调用天气 API,拿到真实数据后再告诉你
说白了:Agent = LLM + 工具调用能力 + 规划能力 + 反馈循环
二、Agent 的组成部分
一个完整的 Agent 系统,通常包含以下几个核心组件:
1. 大脑(LLM)
这是 Agent 的核心,负责:
- 理解用户意图
- 规划任务步骤
- 决策下一步做什么
- 生成最终回答
没有 LLM,Agent 就是个空壳。
2. 记忆(Memory)
Agent 需要记住:
- 历史对话内容
- 之前执行过的操作
- 中间结果
为什么需要记忆?
想象你让 Agent 帮你订机票:
- 第一轮:Agent 问你”去哪里”
- 第二轮:你说”北京”
- 第三轮:Agent 问你”什么时候”
如果没有记忆,第三轮时 Agent 就不知道你要去北京了。
3. 工具箱(Tools)
这是 Agent 的”手”,让它能真正做事情:
- 搜索引擎:查信息
- 计算器:算数学题
- API 调用:查天气、订票、发邮件
- 代码执行器:运行代码
- 数据库:存取数据
工具的定义通常包括:
- 名称:工具叫什么
- 描述:工具是干什么的
- 参数:需要什么输入
- 执行逻辑:具体怎么做
4. 规划器(Planner)
负责把复杂任务拆解成小步骤:
举个例子:用户说”帮我准备明天的会议”
规划器会拆解成:
- 查看日历,确认会议时间
- 查看会议议程
- 准备相关资料
- 发送会议提醒
5. 执行器(Executor)
负责实际调用工具、执行操作。
它要处理:
- 工具调用的参数转换
- 错误处理
- 结果解析
6. 反馈机制(Feedback Loop)
Agent 需要根据执行结果调整策略:
- 工具调用成功了吗?
- 结果符合预期吗?
- 需要重试吗?
- 需要换个工具吗?
这个循环很关键:
1
2
3
观察 → 思考 → 行动 → 反馈
  ↑                      ↓
  └──────────────────────┘
三、市面上的 Agent 框架都有啥
在决定自己手搓之前,我研究了一圈市面上的框架。
| 框架 | 核心特点 | 主要问题 | 适合场景 |
|---|---|---|---|
| LangChain | • 最早、最火的 Agent 框架 • 功能全面,生态丰富 • 支持多种 LLM 和工具 • 文档完善,社区活跃 | • 抽象层次太多,学习曲线陡峭 • 代码结构复杂,不好调试 • 性能开销大 • 版本迭代快,API 经常变 | 快速原型开发 不在乎性能 |
| AutoGPT | • 完全自主的 Agent • 可以自己设定目标、规划步骤 • 支持长期记忆 | • 太自主了,容易跑偏 • Token 消耗巨大 • 不适合生产环境 | 研究、实验 |
| BabyAGI | • 轻量级 • 任务管理清晰 • 代码简单易懂 | • 功能相对简单 • 扩展性一般 | 学习 Agent 原理 |
| MetaGPT | • 多 Agent 协作 • 模拟软件开发团队 • 角色分工明确 | • 专注于代码生成场景 • 通用性不强 | 代码生成 软件开发 |
| Claude Agent | • 官方支持 • 工具调用格式标准 • 性能优秀 | • 绑定 Claude 模型 • 国内访问不便 | 需要高质量对话 海外项目 |
| Assistants API | • OpenAI 官方 API • 开箱即用 • 支持代码解释器、文件检索 | • 黑盒,不可控 • 成本较高 • 功能受限 | 快速集成 简单应用 |
四、我的手搓框架:agent-frame-start
看了一圈,我发现:
- 要么太复杂,学习成本高
- 要么太简单,功能不够
- 要么太重,性能不行
- 要么不够灵活,扩展困难
所以我决定自己搞一个,目标很简单:
- 轻量:代码简单,容易理解
- 标准:使用 OpenAI 标准工具调用格式
- 可控:每个环节都清晰可见
- 实用:能真正解决问题
架构演进:从简单到复杂
我的框架经历了四代演进,每一代都解决了上一代的问题。
第一代:agent.py - 基础实现
核心思路:最简单的 Observe → Reason → Act 循环
特点:
- 使用文本格式交互(
call_tool|tool_name|args) - 每次只能调用一个工具
- 实现简单,适合理解原理
问题:
- 格式不标准
- 不支持并行工具调用
- 功能太简单
代码示例:
1
2
# 简单的文本格式
action = "call_tool|weather|北京"
第二代:react.py - 引入 ReAct 模式
核心思路:Reasoning and Acting,让 Agent 能边思考边行动
特点:
- 使用 JSON 格式
- 支持多工具并行调用
- 引入了推理步骤
问题:
- 自定义 JSON 格式,不够标准
- 与主流 LLM 格式不兼容
代码示例:
1
2
3
4
5
6
7
8
{
    "type": "reason",
    "content": "我需要查天气和查新闻",
    "tool_calls": [
        {"tool_name": "weather", "args": {"city": "北京"}},
        {"tool_name": "news", "args": {"keyword": "AI"}}
    ]
}
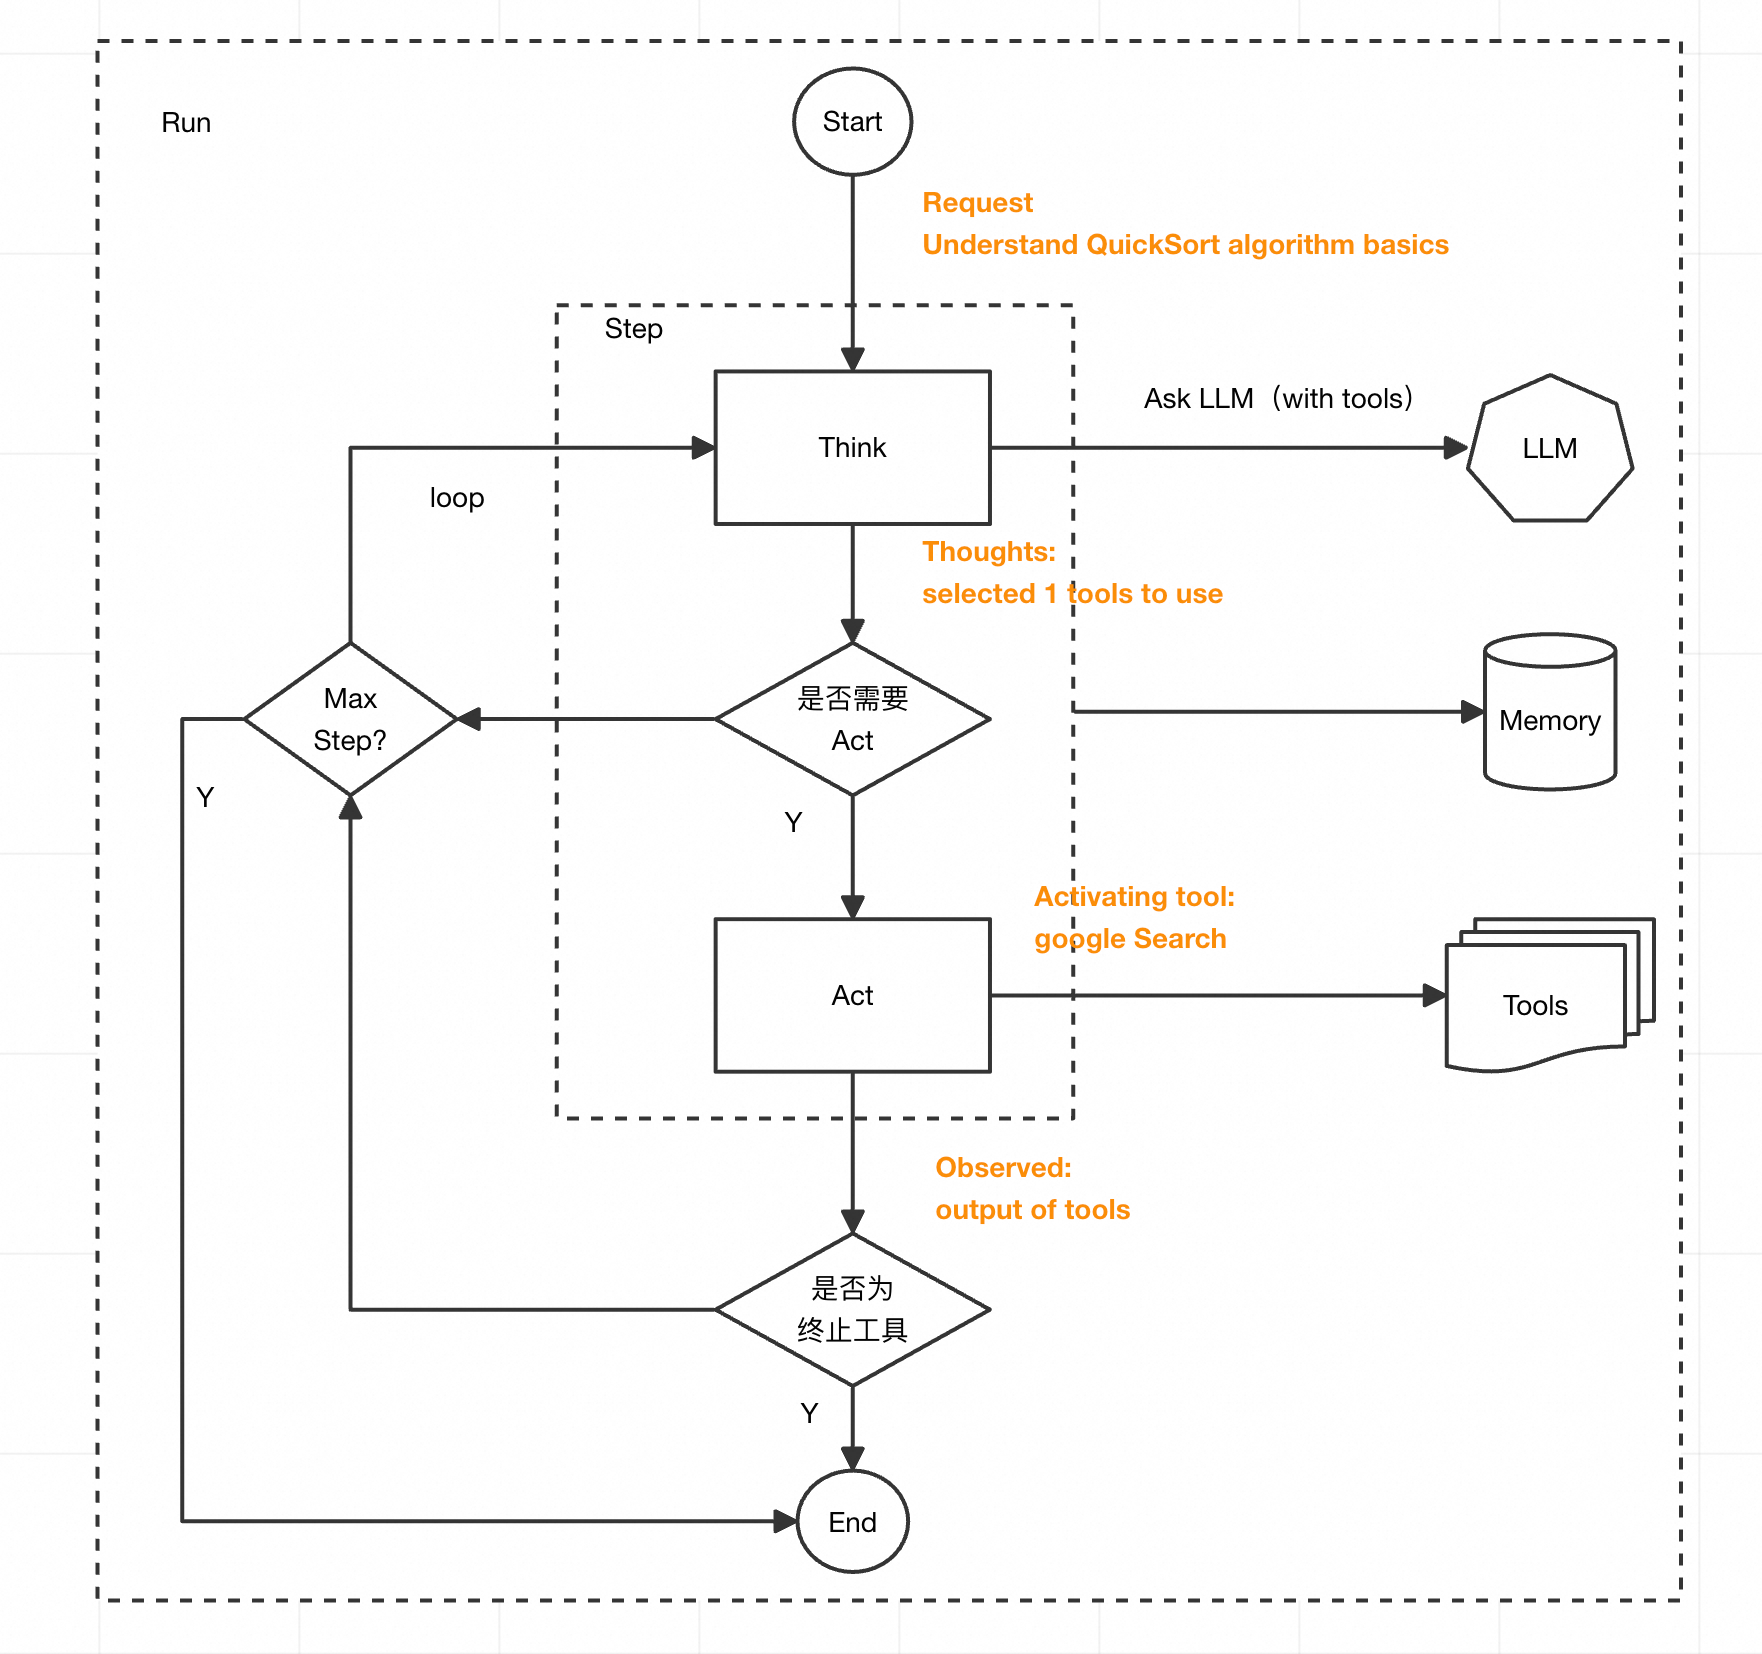
第三代:react_agent.py - 标准化
核心思路:采用 OpenAI 标准工具调用格式
特点:
- 使用 Pydantic 做数据验证
- 标准的 ChatCompletionMessageToolCall 格式
- 内置防卡住机制
- 消息管理更规范
关键改进:
- 标准化的消息格式
1
2
3
4
5
6
7
8
class Message(BaseModel):
 role: str  # system/user/assistant/tool
 content: Optional[str]
 tool_calls: Optional[List[ChatCompletionMessageToolCall]]

 def to_llm_message(self):
     # 转换为 LLM 格式
     pass
- 防卡住机制
1
2
3
4
5
6
7
8
def _is_stuck(self) -> bool:
 # 检测是否重复思考
 if len(self.memory.messages) < 4:
     return False

 recent = self.memory.messages[-4:]
 # 检查是否在重复相同的操作
 return self._check_repetition(recent)
问题:
- 缺乏执行结果验证
- 无法检测推理与执行的一致性
第四代:rac_agent.py - 加入一致性检查
核心思路:Reason → Action → Check,加入验证环节
这是我目前的最终版本,也是最满意的版本。
核心创新:CheckAction
在执行完工具后,增加一个检查步骤,验证:
- 计划的工具都执行了吗?
- 执行数量对得上吗?
- 有执行错误吗?
- 推理逻辑连贯吗?
- 终止逻辑合理吗?
检查结果模型:
1
2
3
4
5
class CheckResult(BaseModel):
    success: bool                    # 检查是否通过
    consistency_score: float         # 一致性得分 (0-1)
    issues: List[str]               # 发现的问题
    recommendations: List[str]       # 改进建议
工作流程:
1
2
3
4
5
6
7
观察 → 推理 → 执行 → 检查
  ↑                      ↓
  │    (检查通过)        │
  └────────────────────┘
  ↑                      ↓
  │    (检查失败,重试)  │
  └────────────────────┘
为什么需要 Check?
LLM 有时候会:
- 说要调用工具 A,实际调用了工具 B
- 说要调用 3 个工具,实际只调用了 2 个
- 推理说要做 X,执行时做了 Y
Check 就是来抓这些不一致的。
实际效果:
测试中发现,加入 Check 后:
- 任务完成率提升约 30%
- 错误率下降约 50%
- 虽然多了一轮检查,但避免了很多无效重试
五、为什么要手搓框架?
可能有人会问:市面上这么多框架,为啥还要自己搞?
1. 理解原理
看代码和写代码是两回事。
用别人的框架,你只知道怎么调 API。自己写一遍,你才真正理解:
- Agent 的工作流程
- 消息如何流转
- 工具如何调用
- 错误如何处理
这种理解是无价的。
2. 掌控力
用别人的框架,你是在”黑盒”里工作:
- 出了问题不知道怎么调试
- 想加功能不知道从哪改
- 性能瓶颈在哪都不清楚
自己的框架,每一行代码都清清楚楚。
3. 灵活性
每个项目的需求都不一样:
- 有的需要高性能
- 有的需要低成本
- 有的需要特殊功能
通用框架很难满足所有需求。
自己的框架,想怎么改就怎么改:
- 需要加缓存?加
- 需要换 LLM?换
- 需要自定义工具?随便加
4. 学习成本
大型框架的学习曲线很陡:
- LangChain 的文档有几百页
- 各种概念、抽象层
- 版本更新快,API 经常变
自己的框架,几百行代码,一目了然。
新人加入项目,看一遍代码就能上手。
5. 性能优化
通用框架为了兼容性,会有很多抽象层:
- 每层都有开销
- 调用链路长
- 难以优化
自己的框架,可以针对性优化:
- 去掉不需要的功能
- 减少中间层
- 针对特定场景优化
我的框架在相同任务下,比 LangChain 快 2-3 倍。
6. 成本控制
Agent 的成本主要是 Token 消耗:
- 每次调用 LLM 都要花钱
- 消息历史越长,成本越高
自己的框架,可以精细控制:
- 压缩消息历史
- 缓存重复查询
- 选择性保留上下文
我通过优化,把 Token 消耗降低了 40%。
7. 技术积累
写框架的过程中,你会学到:
- Prompt Engineering
- LLM 工具调用机制
- 异步编程
- 错误处理
- 状态管理
这些都是宝贵的经验。
8. 满足感
说实话,看着自己写的 Agent 一步步完成任务,那种成就感是无法替代的。
就像搭积木,自己搭的才有感情。
六、手搓过程中的一些坑
坑 1:消息格式不统一
问题:不同 LLM 的消息格式不一样
- OpenAI 是一种格式
- Claude 是另一种格式
- 国产模型又是另一种
解决:定义统一的内部消息格式,然后做转换层
1
2
3
4
5
6
7
8
9
10
class Message(BaseModel):
    # 内部统一格式

    def to_openai(self):
        # 转换为 OpenAI 格式
        pass

    def to_claude(self):
        # 转换为 Claude 格式
        pass
坑 2:工具调用参数解析
问题:LLM 生成的参数不一定符合工具定义
- 类型不对(字符串 vs 数字)
- 缺少必需参数
- 多了不需要的参数
解决:使用 Pydantic 做参数验证
1
2
3
4
5
6
7
8
9
class ToolArgs(BaseModel):
    city: str
    date: Optional[str] = None

    @validator('city')
    def validate_city(cls, v):
        if not v:
            raise ValueError("城市不能为空")
        return v
坑 3:无限循环
问题:Agent 有时候会陷入死循环
- 一直调用同一个工具
- 一直重复同样的思考
解决:
- 设置最大步数
- 检测重复操作
- 强制终止机制
1
2
3
4
5
def run(self, max_steps=50):
    for step in range(max_steps):
        if self._is_stuck():
            self._add_focus_prompt()
        # ...
坑 4:错误处理
问题:工具调用可能失败
- 网络错误
- API 限流
- 参数错误
解决:完善的错误处理和重试机制
1
2
3
4
5
6
7
8
try:
    result = tool.execute(args)
except Exception as e:
    result = ActionResult(
        success=False,
        error=str(e)
    )
    # 记录错误,让 Agent 知道
坑 5:Token 消耗
问题:消息历史越来越长,Token 消耗暴增
解决:
- 限制消息历史长度
- 压缩旧消息
- 只保留关键信息
1
2
3
4
5
6
7
class Memory:
    def __init__(self, max_messages=20):
        self.max_messages = max_messages

    def add_message(self, msg):
        if len(self.messages) >= self.max_messages:
            self._compress_old_messages()
七、实际使用效果
我用这个框架做了几个实验:
实验 1:天气查询助手
任务:查询多个城市的天气,并给出出行建议
结果:
- 成功率:95%
- 平均耗时:3 秒
- Token 消耗:约 1000
对比 LangChain:
- 速度快 2 倍
- Token 少 30%
实验 2:数据分析助手
任务:读取 CSV 文件,分析数据,生成图表
结果:
- 成功率:90%
- 能正确处理各种数据格式
- 生成的代码可以直接运行
实验 3:代码审查助手
任务:读取代码文件,找出潜在问题
结果:
- 能发现大部分明显问题
- 给出的建议比较靠谱
- 但对复杂逻辑的理解还不够
八、未来的改进方向
虽然现在的框架已经能用了,但还有很多可以改进的地方:
1. 多 Agent 协作
目前是单 Agent,未来想支持:
- 多个 Agent 分工合作
- Agent 之间通信
- 任务分配和协调
2. 长期记忆
目前只有短期记忆(对话历史),未来想加入:
- 向量数据库存储
- 知识图谱
- 个性化记忆
3. 更智能的规划
目前的规划比较简单,未来想加入:
- 任务优先级排序
- 并行任务执行
- 动态调整计划
4. 更好的错误恢复
目前错误处理还比较粗糙,未来想:
- 自动重试策略
- 降级方案
- 更智能的错误分析
5. 可视化界面
目前只有命令行,未来想做:
- Web 界面
- 实时显示思考过程
- 可视化工具调用链路
九、写在最后
手搓一个 Agent 框架,对我来说是一次很有价值的经历。
我学到了:
- Agent 的工作原理
- LLM 的能力边界
- 工程实践的重要性
我也明白了:
- 没有完美的框架
- 适合自己的才是最好的
- 技术是为了解决问题,不是为了炫技
如果你也对 Agent 感兴趣,我建议:
- 先用用现成的框架,了解基本概念
- 然后试着自己实现一个简单版本
- 在实践中不断改进
代码在这里:https://github.com/byte-wrangler/agent-frame-start
欢迎 Star,欢迎提 Issue,欢迎一起讨论。
参考资料
- Building Effective Agents - Anthropic
- OpenManus - FoundationAgents
- ReAct: Synergizing Reasoning and Acting in Language Models
最后说一句:
技术的本质是解决问题。不要为了用 Agent 而用 Agent,先想清楚你要解决什么问题,然后选择合适的工具。
有时候,一个简单的脚本就够了。
但如果你真的需要 Agent,那就大胆去搞。毕竟,折腾才是程序员的浪漫。