《逆向 Copilot 有感:从抄到悟,再到进化》
写在前面
最近在做后端基于 SDD 的 AI-Coding 过程中,深刻体会到一个事实:我们自己实现的 ReAct Agent 和业界头部产品(ClaudeCode、Iflow、Qoder 等)之间,差的不是模型,而是工程。
这篇文章记录了我从「逆向 Copilot 的提示词」→「自己 vibe-coding 出一个更强的 Agent」→「思考 Agent 的未来形态」的完整心路历程。
1. 从 Copilot 逆向开始
从做后端基于 SDD 的 AI-Coding 以来,我发现 Copilot 的 Agent 确实非常聪明,可以非常好地理解和执行给定的设计、编码等任务。它的底层其实也是基于 ReAct 的 Agent,但是比我们最初实现的 ReAct Agent 要聪明和鲁棒性强太多了,我想知道为什么他们做的 Agent 可以这么聪明。
然后发现在 Copilot 中,可以打开「开发者工具 DevTools」抓包,能看到实际发送给后端的消息,里面有发送给大模型的完整提示词。
- 完整提示词参考:blob/main/doc/copilot_chat.json
发现在 -Copilot 的上下文管理(Context-Engineering, Harness Engineering)中,核心做了下面几件事情,而这些在初版的 ReAct Agent 中做的完全不够:
- 对系统提示词进行了深入的定制优化
- 对消息进行了 hook 做动态提醒
- 创建计划、计划的依赖关系、计划的状态管理、动态调整计划
- 观察到的异常信息、任务的实时状态会补充到上下文
- 历史上下文有智能压缩的能力
- 任务执行是可并发的
这 6 件事看起来朴素,但每一件都是工程细节决定的能力上限。
2. 如果我无法构建,我就没有学会
既然知道了差距在什么地方,就可以补齐差距,所以 vibe-coding 了一个 ClaudeCode 风格的 agent,我想看看加上了上面缺失的部分之后,是否可以得到一个功能、性能、稳定性更强的 Agent。
- bb-agent:bb-agent/blob/main/README.md
🍰 bb-Agent - AI 智能体 CLI
Python ≥3.10·License MIT·MCP Supported交互式对话 · 单次任务执行 · Shell / 文件读写 / MCP Server · 自主完成复杂任务
2.1 核心技术架构
- 核心技术文档:bb-agent/blob/main/doc/runtime.md
- 核心模型架构:
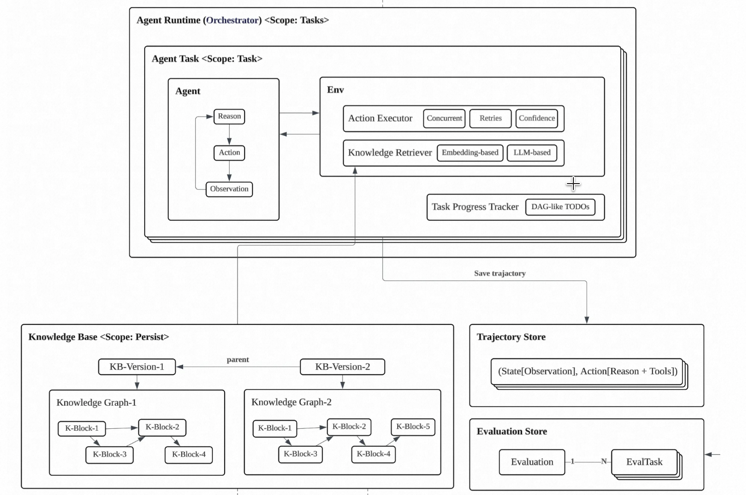 整体分为三个 Scope:
- Agent Runtime(Orchestrator) <Scope: Tasks>:多任务编排层,负责 Agent Task 的提交、调度、取消
- Agent Task <Scope: Task>:单任务执行层,由 Agent(Reason → Action → Observation 循环)和 Env(Action Executor、Knowledge Retriever、Task Progress Tracker)组成
- Knowledge Base <Scope: Persist>:持久化层,KB 按版本管理(KB-Version-1 ← parent ← KB-Version-2),每个版本内包含 Knowledge Graph(由 K-Block 组成的有向图)
- Trajectory Store / Evaluation Store:轨迹与评测存储,轨迹由 (State[Observation], Action[Reason + Tools]) 构成,为后续的评测与进化提供数据基础
2.2 核心优化点:架构对比
![架构对比表]
| 维度 | 传统 ReAct Agent | bb-Agent Runtime |
|---|---|---|
| 循环模式 | Observe → Thought → Act 三步循环 | Plan → Reason → Act → Observe → Replan 五阶段状态机 |
| 任务规划 | ❌ 无规划能力,逐步试探 | ✅ LLM 生成结构化 Plan,步骤间支持依赖关系 |
| 进度跟踪 | ❌ 无进度概念,仅靠 step 计数 | ✅ DAG 任务图(TaskProgressTracker),支持并行步骤、依赖解锁、失败传播 |
| 重规划能力 | ❌ 无法调整策略,只能在原路径上重试 | ✅ 连续失败或动作重复时自动触发 Replan,LLM 基于历史观察生成新计划 |
| 状态管理 | 2 个状态(RUNNING / IDLE) | 8 个状态的有限状态机,严格校验状态转换合法性 |
| 上下文管理 | 简单 FIFO 截断(max_messages=100) | ShortMemory:LLM 驱动的智能压缩,保留关键信息、丢弃冗余细节 |
| 动作执行 | 串行执行,无重试、无超时 | ActionExecutor:并发执行(信号量控制)、自动重试、超时保护、置信度评分 |
| 工具体系 | OpenAI function calling 绑定,工具直接耦合在 Agent 中 | ActionHandler 抽象接口 + MCP 协议,工具与 Agent 完全解耦 |
| LLM 集成 | 单一 LlmCaller 直接调用 OpenAI API | 三层解耦:PromptBuilder(提示词构建)→ AgentLLM(编排)→ LLMBackend(多供应商适配) |
| 多任务 | ❌ 单任务同步执行 | ✅ AgentRuntime 多任务编排,支持并发提交、取消、进度订阅 |
| 持久化 | ❌ 无持久化,进程结束即丢失 | ✅ SQLAlchemy 持久化(任务状态 + 状态快照),支持断点恢复 |
| 可观测性 | emit_event 简单事件打印 | MessageBus 发布/订阅 + PerformanceMonitor 性能指标 + 结构化日志 |
| 错误处理 | try/except 捕获后返回错误字符串 | 分层错误体系(EvoAgentError → LLMError / ActionError / ConfigError 等) |
然后我发现,真的可以做出来一个功能、性能、稳定性更强的 Agent,实际上的执行步骤和执行结果跟 ClaudeCode、Iflow、Qoder、Copilot 的核心功能已经很像了,差别在于他们可能有更强的工具(比如:codebase_search、read_ali_doc 等)。
3. 转变思路:核心是构建好让 Agent 友好的上下文环境
在上个财年的 AI 业务实践中,我们主要是规定业务动线(代码串联 或 workflow),比如:
- 智能助理:通过代码串联模型的调用,根据结果做表单回填
- 智能审核:通过工作流来串联模型的调用,得到审核结果
- 智能律师函:通过代码串联模型调用,根据结果做表单回填
上面的核心是,大模型提供单点能力,然后用代码/工作流来串联这些能力,这些的问题在于,前期构建简单,但是越往后越难提升,因为:
- 灵活性不够,无论是构建还是执行
- 不可能覆盖所有的场景,总有例外情况,实际上业务也无法提前预知所有的场景
- 多个产品串联业务很难调试
- 各产品责任不同,不可能具体场景深度定制
真正正确的事情是先困难,做了之后越往后做越容易,而不是越往后越困难。
但是,如果我们有一个更强的 Agent,或者如果我们知道如何在某个领域构建一个更强的 Agent,那可做的事情就很多了,未来的目标应该是 让 Agent 来做任务的串联和调度,而不是代码/工作流来调用,这是趋势。如果这是最后的必然形态,那不如以终为始,一开始就从这个角度开始设计与构建。
因此,转变一下思路,我们应该核心负责提供能力(Tool、MCP、SKILL),然后让一个强大的 Agent 来调度能力去执行:
- Agent 做的不好的话,我们去优化「能力」和「Agent 如何使用能力」(Context-Engineering)
- Agent 错了不要紧,核心是让 Agent 在上下文中感知到错误信息,它就能自己纠正
- Agent 执行与反馈的链路应该越短越好,反馈链路越短,AI 产品就越好用。最好能把这个反馈环控制在单一的产品上,比如:IDE 里的 CoderAgent 就很好用,因为「AI 写代码」和「执行错误反馈给 AI」都在 IDE 里面,这个反馈链路很短,就能很快有效
4. Evaluation:Agent 的”考试系统”
不过上面的优化过程,只是这个项目的插曲,项目之所以叫 bb-agent,是因为核心目标是 Evolution(进化)。
要让 Agent 进化,首先得有一把”尺子”能量化评估它。bb-Agent 的 Evaluation 架构如下:
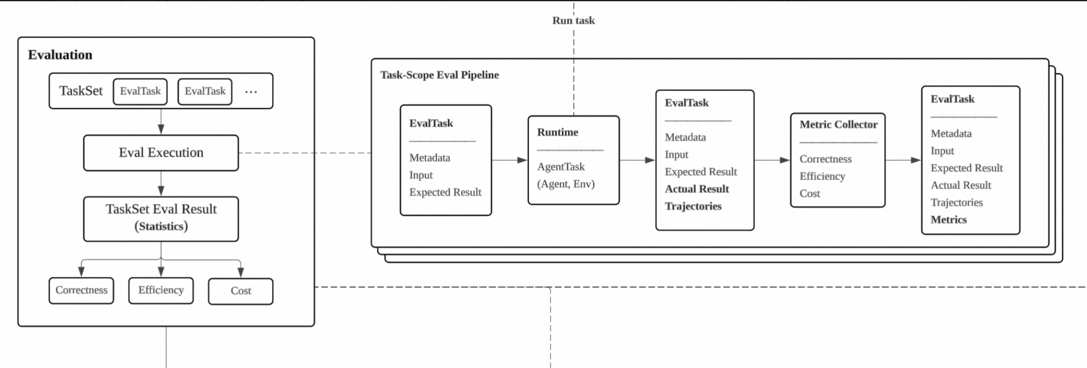 整个评测体系分两层:
- 左侧 Evaluation:由
TaskSet(一组EvalTask)驱动Eval Execution,最终输出TaskSet Eval Result (Statistics),聚合为三大核心指标 —— Correctness(正确性)、Efficiency(效率)、Cost(成本) - 右侧 Task-Scope Eval Pipeline:对每个
EvalTask(包含 Metadata、Input、Expected Result),交给Runtime (AgentTask = Agent + Env)执行,得到Actual Result + Trajectories,再经由Metric Collector计算 Correctness/Efficiency/Cost,最终产出带Metrics的 EvalTask
有了这个评测系统,”这个 Agent 是否变强了”就不再是拍脑袋的感受,而是可量化的数字。
5. Knowledge Optimization Pipeline:Agent 的”进化算法”
有了考试系统(Evaluation),就可以开始进化了。Knowledge Optimization Pipeline 的核心思路:
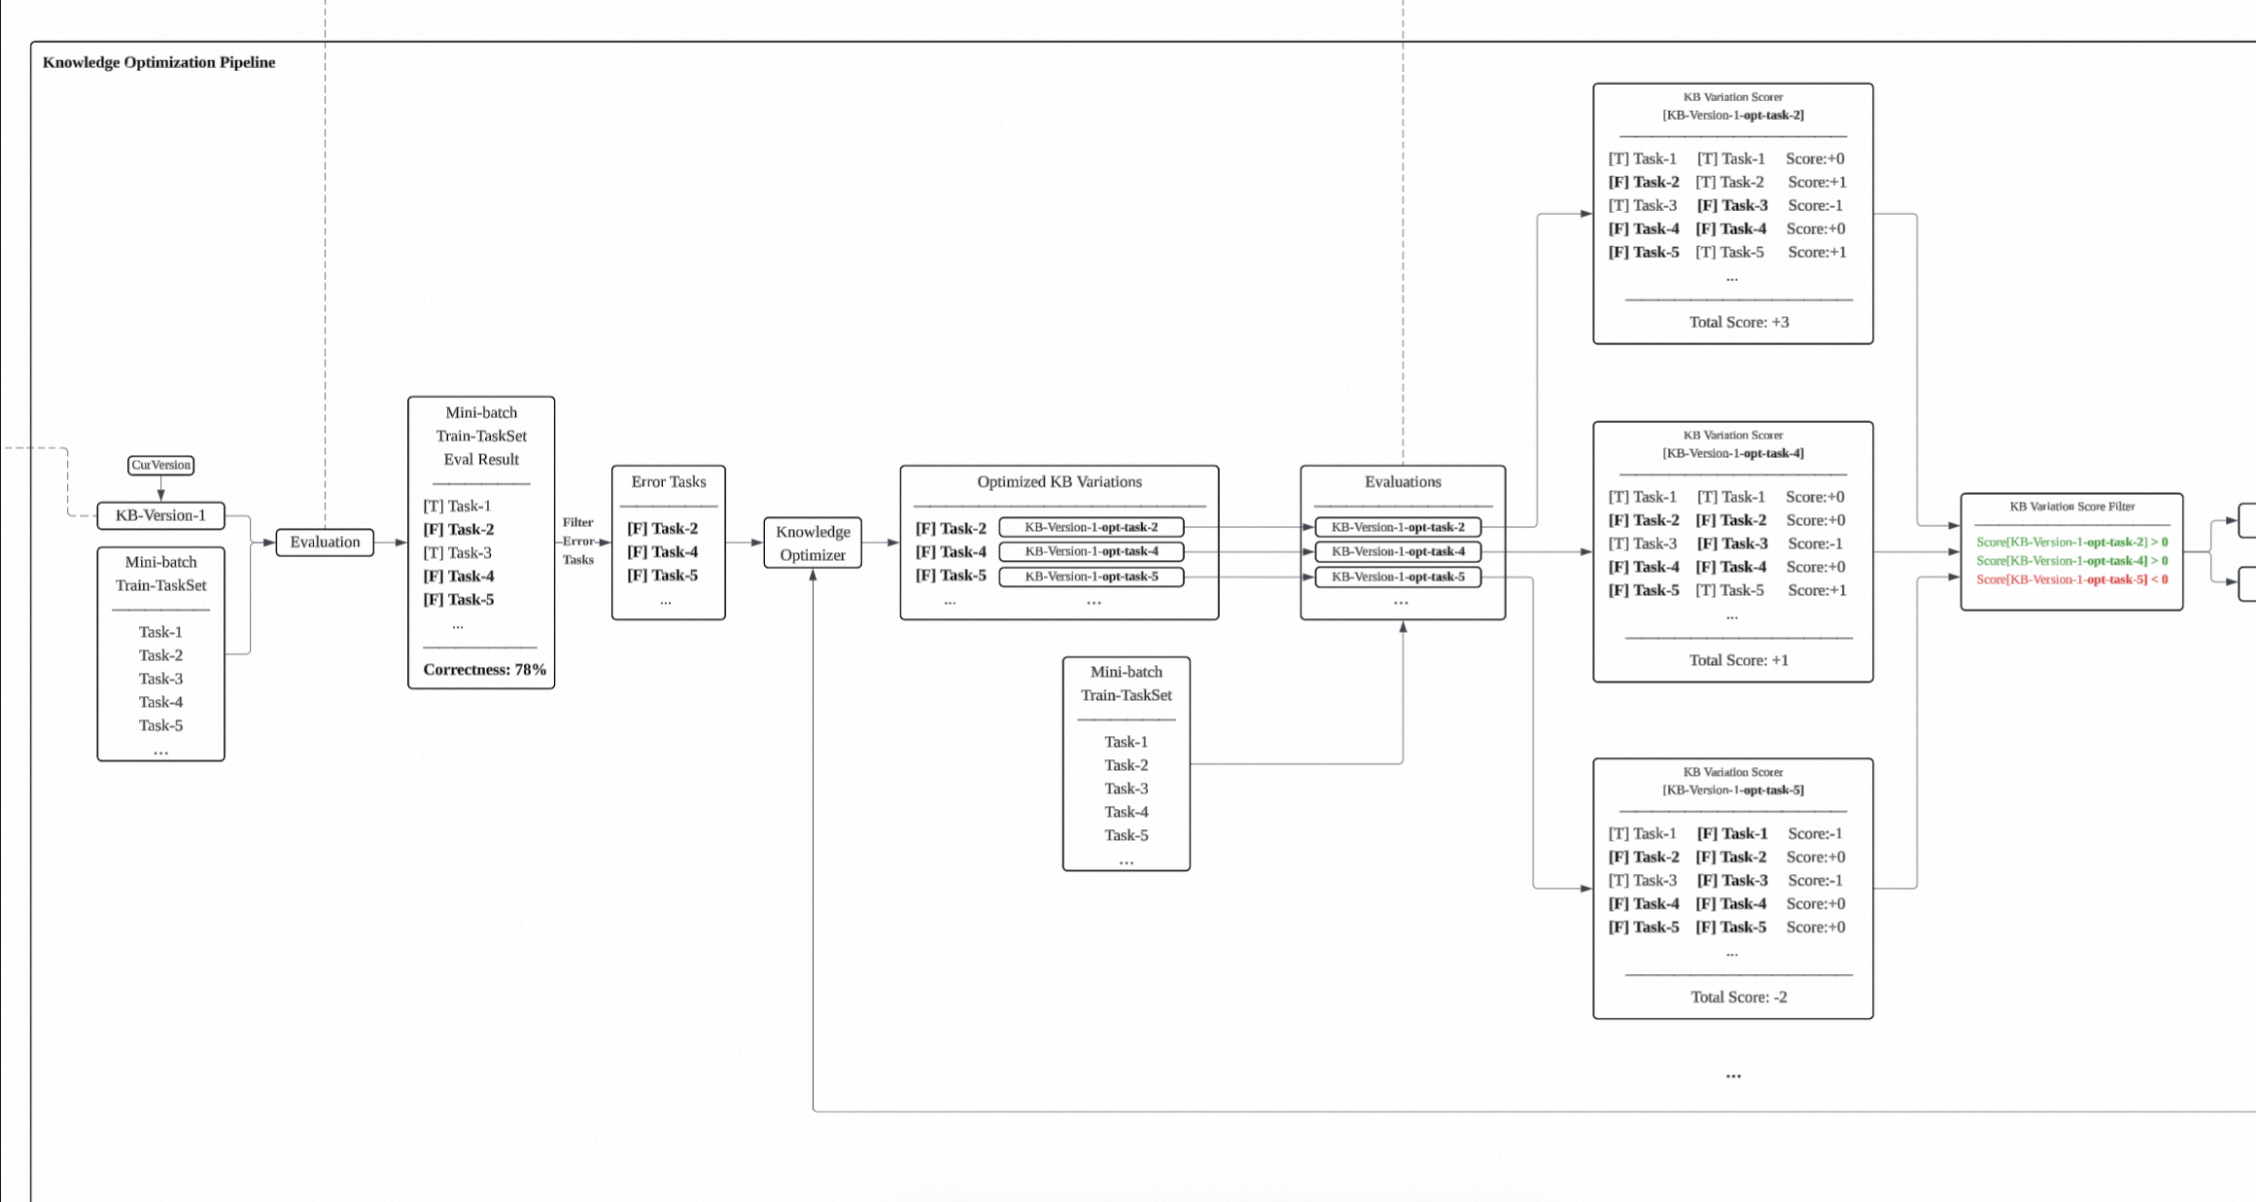
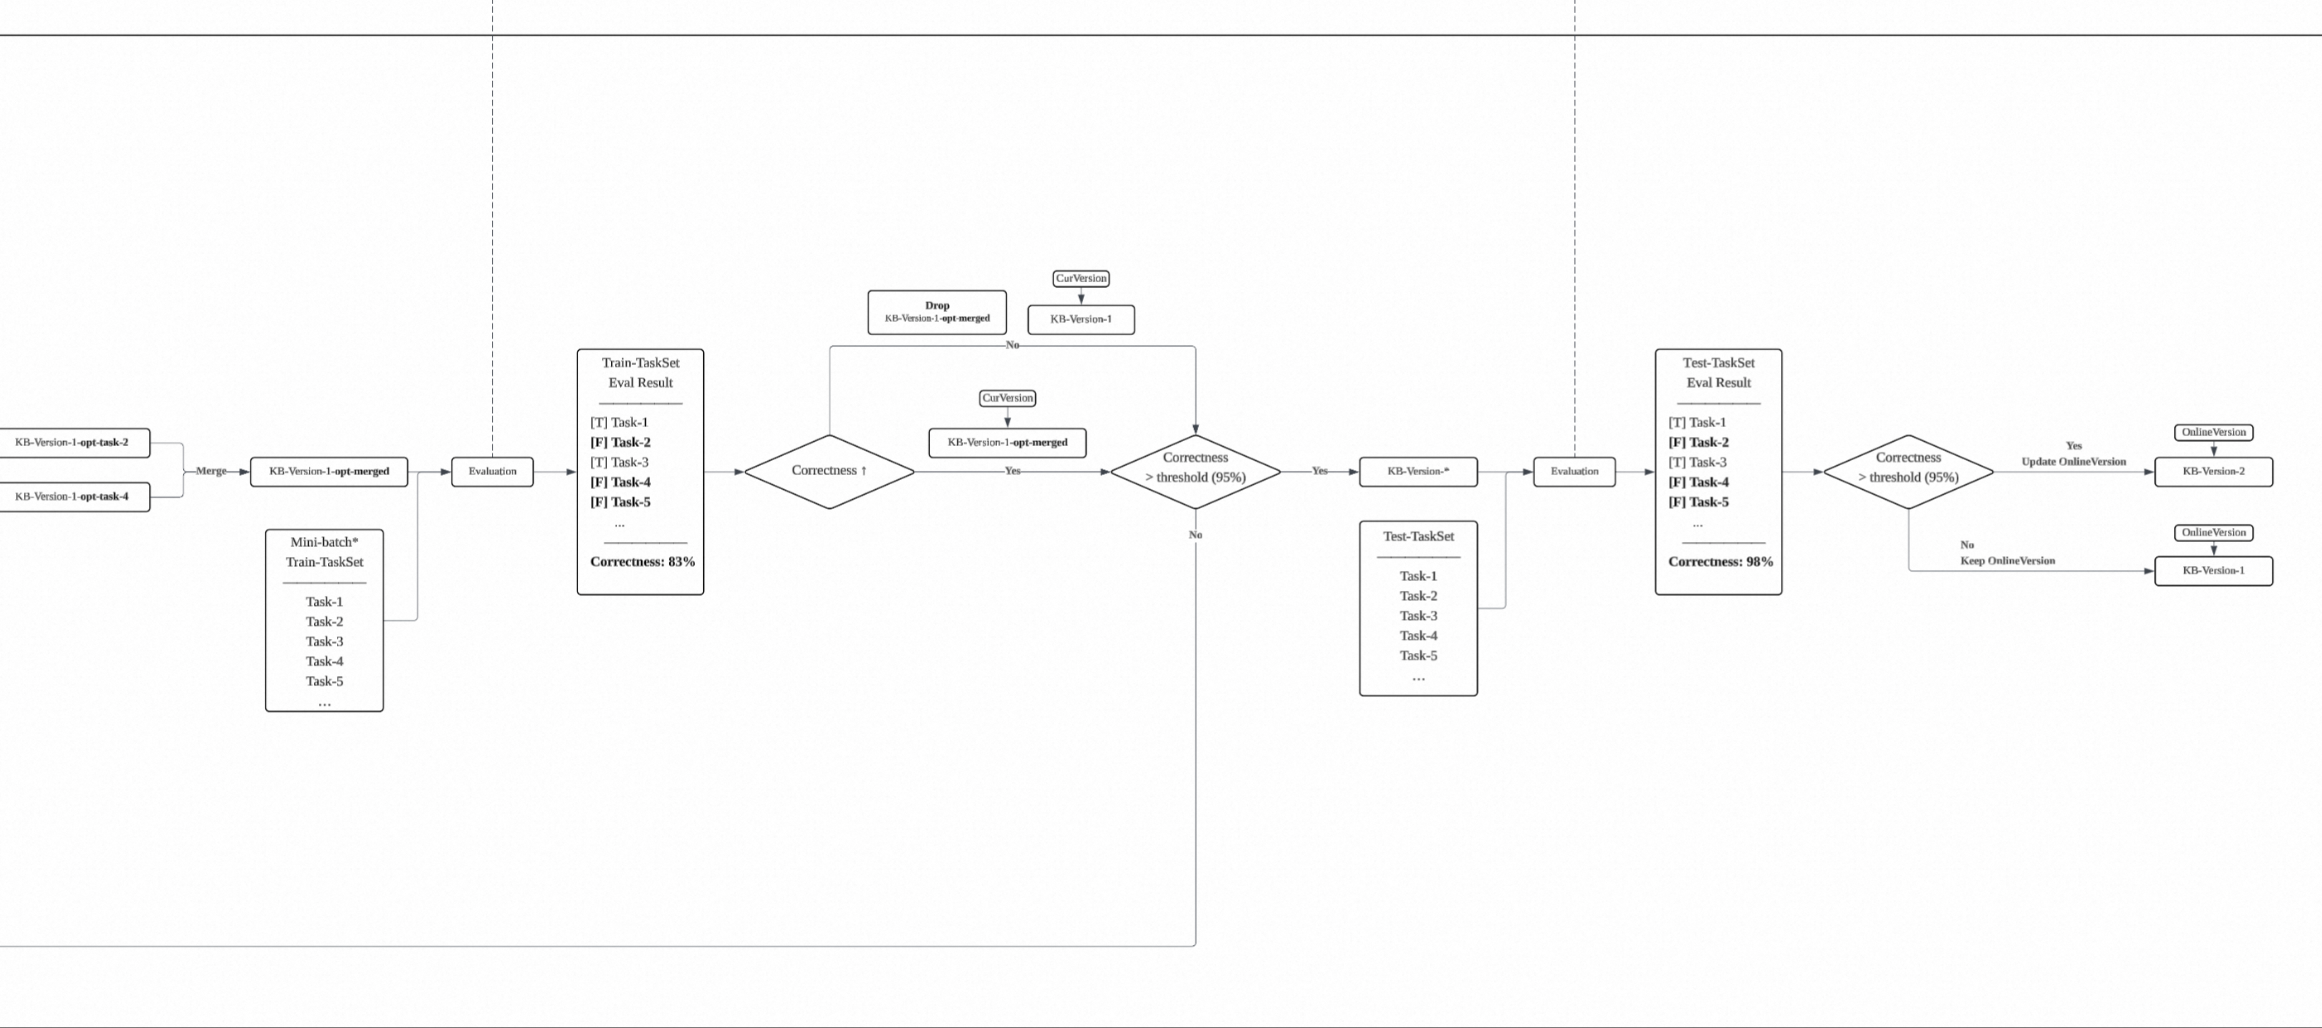 整条流水线从左到右的关键节点:
- 起点:
KB-Version-1+Mini-batch Train-TaskSet做 Evaluation,得到 Eval Result(例:Correctness 70%),标记出[T] 通过任务与[F] 失败任务 - 筛错:Filter 出 Error Tasks(如 Task-2、Task-4、Task-5)
- 优化:
Knowledge Optimizer针对每个 Error Task 生成一个 KB Variation(KB-Version-1-opt-task-2、opt-task-4、opt-task-5) - 打分:对每个 Variation 在 Mini-batch Train-TaskSet 上评测,通过
KB Variation Scorer比较与原版的 T/F 变化(原本 T 现在还是 T 记 0 分,原本 F 变 T 记 +1,原本 T 变 F 记 -1),得到每个 Variation 的 Total Score(如 +3 / +1 / -2) - 过滤合并:
KB Variation Score Filter仅保留Score > 0的 Variations,Merge 为KB-Version-1-opt-merged - 训练集复评:在 Train-TaskSet 上重新评测合并版本(例:Correctness 83%),若超过
threshold (90%)则晋级为新的KB-Version-*,否则 Drop - 测试集把关:在 Test-TaskSet 上做最终评测(例:Correctness 90%),若超过
threshold (95%)则Update OnlineVersion → KB-Version-2,否则Keep OnlineVersion → KB-Version-1
这个流程的精髓在于:
- 从错误中学习:只对 Error Tasks 做优化,聚焦真正的薄弱点
- 变异-筛选:生成多个优化变体(Variations),通过 T/F 变化打分,只合并真正带来净提升的
- 双阈值保护:Train-TaskSet(90%)+ Test-TaskSet(95%)双重验证,避免过拟合
- 版本化管理:KB 像 Git 一样有版本和 parent 关系,可回滚、可追溯,线上版本仅在通过测试集阈值后才更新
这其实是把遗传算法 / 强化学习的思想,落到了 Agent 知识库的优化上。
6. 前沿工程创新
这也是我们能做的前沿工程创新的地方,当前的 Agent 进化已经有一些业界的工程实践了,比如:
- EvoMap:https://github.com/EvoMap/evolver
- OpenClaw 自我进化:https://zhuanlan.zhihu.com/p/2012469322396770989
这些项目的原理是类似的,不过他们基本是通用场景的 agent 进化模式,而我们面对的是特定业务域的大规模 agent 进化,意味着我们有更多领域专属的数据和领域定制优化的能力,并且进化后的 Agent 可以作为全体 Agent 的下次审核的基础,形成真正的飞轮。
写在最后
从逆向 Copilot 的提示词,到 vibe-coding 出 bb-agent,到思考 Context-Engineering 的本质,再到设计 Evaluation 与 Optimization Pipeline,这条路让我意识到:
Agent 的竞争,最终是工程能力的竞争,而不是谁有更强的模型。
不过上面的优化过程,只是这个项目的插曲,项目之所以叫 bb-agent,是因为核心目标是 Evolution(进化)。如何通过 Evaluation(评测)和 Optimization Pipeline(优化流水线),让 agent 通过进化算法持续进化,是后面会 vibe-coding 的部分,有进展了再同步。
—— 以终为始,从今天开始构建会进化的 Agent。