《LLM个人笔记》
写在前面
最近一两年,AI 这个词火得不行,尤其是 ChatGPT 横空出世之后,身边的朋友都在讨论”大模型”、”LLM”这些概念。作为一个技术人,我也花了不少时间去了解和使用这些工具。
一、LLM 到底是啥
先说说名字
LLM 全称是 Large Language Model,翻译过来就是”大语言模型”。
这名字听起来挺唬人,其实拆开来看就好理解了:
- Large(大):模型参数量巨大,动辄几十亿、上百亿个参数
- Language(语言):专门处理人类语言的
- Model(模型):就是一个数学模型,通过训练学会了某种能力
用人话说就是
想象一下,你有个特别博学的朋友,他读过海量的书籍、文章、对话记录。当你问他问题时,他能根据之前看过的内容,给你一个看起来很靠谱的回答。
LLM 就是这么个东西,只不过它”读过”的内容比任何人都多得多,而且”记忆力”也强得多。
用个更形象的比喻
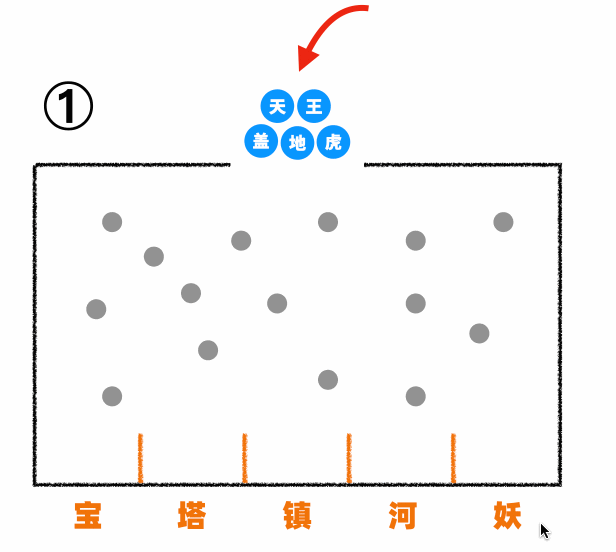
我看到过一个特别有意思的比喻,把 LLM 比作一台”弹珠机”:
想象有一台弹珠机,弹珠落下时会碰到钉子改变方向,最后落到不同位置。每个弹珠代表一个字,每个位置也代表一个字。
当你丢下”天”、”王”、”盖”、”地”、”虎”这5颗弹珠后,经过钉子的碰撞,所有弹珠都落在了”宝”这个位置。然后再把这些弹珠加上新的”宝”字弹珠一起丢下去,又都落在了”塔”这个位置。就这样循环几次,神奇地接出了”宝”、”塔”、”镇”、”河”、”妖”。
这台弹珠机为什么这么神奇?
因为钉子数量足够多(上百亿个),每个钉子的位置都经过反复测试精心调整。经过反复调教的弹珠机,就是训练好的大模型。
LLM 的工作原理:词语接龙
说白了,LLM 就是在玩”词语接龙”游戏:
- 你输入一个问题
- LLM 把问题扔进自己的”词向量空间”
- 按照权重寻找答案,找距离最近的词作为下一个词
- 前面串联过的所有词一起决定下一个词是什么
- 就这样一个词一个词地连成句子输出给你
重要的是:LLM 并没有一个巨大的数据库来存储答案。每个答案都是根据你的问题现场组织、现串现卖的,属于你的专属答案。
而且,LLM 对世界的认知停留在训练停止的那一天。它不会因为跟你聊天产生新记忆,更不会从你那学到新东西。
它能干啥?
说白了,LLM 就是个”文字处理专家”,能做的事情包括但不限于:
- 聊天对话:像 ChatGPT 那样,能跟你一来一回地聊天
- 写文章:帮你写邮件、报告、文案,甚至写代码
- 翻译:把中文翻译成英文,或者其他语言
- 总结归纳:把一大段文字提炼成几句话
- 回答问题:像个百科全书一样回答各种问题
- 代码辅助:帮程序员写代码、找 bug、解释代码逻辑
二、LLM 的优点和缺点
先说说优点
1. 理解能力强
LLM 能够理解你输入的意图,这点很厉害。你不需要用特定的格式或关键词,用自然语言说话就行。
它能从你的描述中抓住重点,理解你真正想问什么。
2. 知识面广得离谱
LLM 训练时”看过”的内容涵盖了互联网上的大量文本,从科技、历史、文学到编程、医学,几乎无所不包。
你问它问题,大概率能给你一个还算靠谱的答案。这比自己去搜索引擎翻半天资料要快多了。
3. 有基本的推理能力
LLM 不只是简单地检索信息,它还能进行基本的推理。
比如让它总结文本、从海量信息中提取关键点、分析问题等,这些都需要一定的推理能力。
4. 24 小时随叫随到
不像人类助手,LLM 不需要休息,不会请假,也不会因为心情不好而敷衍你。
半夜三点突然想到个问题?没关系,它随时在线。
5. 效率高到吓人
写个邮件、整理个会议纪要、生成个代码模板,这些事情对 LLM 来说就是秒秒钟的事。
以前可能要花半小时的工作,现在几分钟就搞定了。
6. 不会嫌你问题傻
有些问题你可能不好意思问同事或者老师,怕被笑话。但问 LLM 就没这个顾虑,它不会评判你,只会尽力回答。
7. 能举一反三
给它一个例子,它能生成类似的多个变体。比如你给它一个邮件模板,它能根据不同场景生成不同版本。
再说说缺点
1. 会一本正经地胡说八道(幻觉问题)
这是 LLM 最大的问题,也是阻碍它落地应用的最重要原因。
它有时候会非常自信地给你一个错误答案,而且说得跟真的一样。比如你问它某个历史事件的日期,它可能会编造一个看起来很合理的日期,但实际上是错的。
这个现象有个专业术语叫”幻觉”(Hallucination)。
为什么会出现幻觉?
主要有两方面原因:
数据层面:
- 训练语料不足:某些领域的数据太少,或者数据偏向某一方面
- 数据不够干净:训练数据里有噪声、错误信息、不符合实际的言论
- 小众知识缺失:虽然喂了海量数据,但有些独特的信息,大模型未必能准确调出
模型层面:
- 预测机制的问题:LLM 是基于当前所有词生成下一个词,采用采样过程有随机性。某个词错了,后面就集体”脱轨”
- 过拟合:在训练数据上表现好,但泛化能力弱,遇到新问题就不行了
- 提示词迷惑:你的问题不够明确或有歧义,LLM 不懂你,就像开发不懂产品经理一样
2. 缺乏专业深度
虽然 LLM 知识面很广,但在专业领域往往不够深入。
原因很简单:不可能把世界上所有信息都数字化来训练大模型,特别是缺乏企业内部的专业数据。
所以在一些专业领域,LLM 的回答可能比较浅显,甚至不准确。
3. 推理能力有限
虽然 LLM 有基本推理能力,但遇到复杂推理就不行了。
为什么? 因为 LLM 本质是个”词语接龙”游戏,更多是基于相关性而非因果性进行预测。
推理通常需要抽象思维和因果关系理解。比如解数学题,过程往往不是线性的,需要先规划、再执行。
所以 LLM 不擅长:
- 复杂的逻辑推理
- 需要多步规划的任务
- 需要深度思考的问题
就像鹦鹉学舌,说得再像,也不代表它真懂。
4. 知识有时效性
LLM 的知识来自训练数据,而训练数据是有截止日期的。
比如 GPT-3.5 的知识截止到 2021 年 9 月,你问它 2022 年发生的事情,它就不知道了。
5. 容易被”带偏”
如果你在对话中给它一些错误信息,它可能会基于这些错误信息继续回答,而不会质疑你。
6. 缺乏常识和判断力
LLM 在处理一些需要常识或者道德判断的问题时,可能会给出不合适的答案。
比如你问它”怎么伤害别人”,早期的模型可能真的会给你一些建议(当然现在都加了安全限制)。
7. 成本不低
训练一个大模型需要海量的计算资源和电力,成本高得吓人。使用 API 也是按调用次数收费的,用多了也是一笔不小的开支。
三、使用 LLM 常见的坑
1. 过度依赖,不加验证
问题:直接把 LLM 的回答当成标准答案,不做任何验证。
后果:可能会被错误信息误导,尤其是在专业领域。
建议:
- 把 LLM 当成”助手”而不是”专家”
- 重要信息一定要交叉验证
- 涉及专业领域的问题,最好咨询真正的专家
2. 提问不清晰
问题:问题描述模糊,导致 LLM 理解偏差。
例子:
- ❌ “帮我写个代码”(太笼统)
- ✅ “帮我用 Python 写一个函数,输入是一个整数列表,输出是列表中的最大值”
建议:
- 提供足够的上下文
- 说清楚你的需求和期望
- 必要时给出示例
3. 把 LLM 当搜索引擎用
问题:问一些需要实时信息或者精确数据的问题。
例子:
- “今天天气怎么样?”
- “某某股票现在多少钱?”
- “最新的 iPhone 价格是多少?”
建议:
- 这类问题还是用搜索引擎或者专门的工具
- LLM 更适合回答概念性、分析性的问题
4. 期望它能做所有事
问题:以为 LLM 是万能的,什么都能做。
现实:
- 它不能访问互联网(除非特别配置)
- 它不能执行真正的代码(只能生成代码)
- 它不能处理图片、视频(除非是多模态模型)
- 它不能帮你做决策(只能提供参考)
建议:
- 了解 LLM 的能力边界
- 选择合适的工具做合适的事
5. 忽视隐私和安全
问题:把敏感信息直接输入给 LLM。
风险:
- 你的输入可能会被用于训练
- 敏感信息可能会泄露
- 商业机密可能会被窃取
建议:
- 不要输入个人隐私信息(身份证号、密码等)
- 不要输入公司机密
- 使用企业版或者私有部署的模型
6. 不会追问和引导
问题:得到一个不满意的答案就放弃了。
技巧:
- 如果答案不满意,可以追问:”能再详细一点吗?”
- 可以换个角度问:”从另一个角度来看呢?”
- 可以给出反馈:”这个答案不太对,应该是…”
建议:
- 把对话当成一个迭代的过程
- 多轮对话往往能得到更好的结果
7. 代码直接复制粘贴
问题:LLM 生成的代码直接拿来用,不做任何检查。
风险:
- 代码可能有 bug
- 代码可能不符合你的实际需求
- 代码可能有安全漏洞
建议:
- 仔细阅读生成的代码
- 理解代码的逻辑
- 测试代码是否正确
- 根据实际情况调整
8. 忽视版权问题
问题:直接使用 LLM 生成的内容,不考虑版权。
风险:
- 生成的内容可能侵犯他人版权
- 商业使用可能有法律风险
建议:
- 了解使用条款
- 重要内容最好人工审核和修改
- 商业用途要特别谨慎
四、我的一些使用心得
1. 把它当成”初稿生成器”
我现在写文章、写代码,经常先让 LLM 生成一个初稿,然后我再基于这个初稿进行修改和完善。
这样效率高很多,而且不容易有”空白页焦虑”。
2. 用它来学习新知识
遇到不懂的概念,我会先问 LLM,让它用简单的语言解释。
然后再去查资料深入学习。这样能快速建立一个初步的认知框架。
3. 让它帮我整理思路
有时候脑子里有很多想法,但是比较乱。我会把这些想法告诉 LLM,让它帮我整理成条理清晰的大纲。
4. 用它来做头脑风暴
需要创意的时候,我会让 LLM 给我提供一些思路。
虽然不一定都能用,但往往能激发我自己的灵感。
5. 把它当成”橡皮鸭”
程序员都知道”橡皮鸭调试法”——把问题讲给橡皮鸭听,往往就能想明白。
LLM 就是个很好的”橡皮鸭”,而且它还能给你反馈。
五、LLM 的实际应用场景
了解了 LLM 的优缺点,我们来看看它在实际中能做什么。
1. AIGC(AI 生成内容)
这是目前最火的应用方向。利用 LLM 的理解能力和知识库,文能提笔写代码,武能上阵画美图。
举个例子:开网店
- 给店铺起名
- 做 Logo
- 写详情页文案和图片
- 写短视频脚本
- 写推广文案
现在聊天机器人、AI 伴侣等产品层出不穷,都是基于这个能力。
2. 信息检索和知识管理
虽然 LLM 有庞大知识库,但内容不一定符合我们需求,还有幻觉问题。
更好的做法是:利用 LLM 的理解和推理能力,结合:
- 个人笔记
- 搜索结果
- 企业内部资料
帮助我们提取真正需要的信息。
目前 AI 搜索、AI 笔记、文档阅读等产品都是这个思路。
3. AI Agent(智能代理)
这是我觉得最有潜力的方向。
什么是 Agent?
简单说,Agent 就是借助 LLM 的推理能力,对复杂任务进行规划拆解,然后调用各种工具去执行。
举个例子:
假设你是服装厂老板,想知道接下来该生产什么衣服。
纯 LLM 的回答:
- 直接问 LLM,它会给你一些看似有道理的建议
- 但实际上听君一席话,如听一席话,没啥实际价值
Agent 的做法:
- 任务分解
- 影响销量的因素:天气、流行趋势、原料成本、自身产品等
- 拆成小任务:查天气预报、查流行趋势、查友商爆款、查原料价格等
- 行动与反馈
- 调用天气 API 查未来一个月天气
- 搜索社交媒体了解潮流趋势
- 爬取电商平台的爆款数据
- 查询原料市场价格
- 根据每个结果调整策略
- 综合决策
- 把所有信息汇总
- 给出具体建议
这就是人类解决复杂问题的方式:
- 将大目标拆分成小目标
- 逐个击破
- 根据反馈调整策略
- 重复这个过程直到找到答案
Agent 就是让 AI 模仿这个过程,代替人类完成思考和行动。
对比一下:
| 方式 | 流程 |
|---|---|
| 大模型交互 | 用户输入 → 模型输出 → 用户评判 → 调整提示词 |
| Agent 交互 | 用户输入 → Agent 自动拆分任务 → 判断优先级 → 调用工具 → 反思评估 → 优化策略 → 汇总输出 |
Agent 的关键在于”大脑”部分,也就是规划决策。大语言模型的出现,让这个逻辑框架的实现成为可能。